平时做技术实践时,很多问题不是概念不会,而是细节没串起来。拿“聊聊SQL Server 数据库迁移的那些坑,看 KES 如何做到代码几……”来说,它看着像小点,放到项目里常会牵出环境、配置、兼容性和维护成本。下面按实际采用顺序,把思路、关键写法和容易踩坑的地方讲清楚,便于大家直接对照操作。
落到代码里,SQL Server 迁移真正的难点不在搬数据,而在海量存量 T-SQL 代码的兼容。金仓 KES V9R4C019 借助深度兼容模式,让绝大多数存储过程、函数和报表 SQL 无需改动或仅需极少量修改 即可直接运行,重点在于它不只是兼容几个关键字,而是从语法、语义到行为细节都做了对齐,同时且必须配合正确的兼容模式采用。
落到代码里,最近这大半年,我一直在帮几个大客户做国产化替换的活儿。说实话,说到SQL Server数据库迁移,大家最怕的往往不是导数据。数据倒来倒去,用个KDTS工具,哪怕几百G的库,跑一晚上也就过去了。真正让人头秃的,是应用代码的改造。
理解这一步时,你想想看,很多老系统,十几年积累下来,几千个存储过程,再加上一堆触发器和自定义函数。里面全是T-SQL的特有写法。你要把这些逻辑全用人肉翻译成别家数据库的语法,这工作量简直不敢想。而且稍不留神,改错一个逻辑,上线就是大事故。那么有没有一种办法,能让这些存量代码几乎不用改就能跑起来呢?今天咱们就借着金仓最新的KES V9R4C019版本,好好拆解一下它是怎么借助深度兼容,把T-SQL语法给接住的。
一、做SQL Server迁移,为啥大家总卡在语法上
从实现思路看,其实如果你做过从SQL Server往别的库迁的项目,你肯定有体会。表结构能对上,数据能灌进去,这仅仅只是万里长征的第一步。真正的硬骨头在后面。
1.1 存量T-SQL代码太重了
理解这一步时,以前在微软的体系下,开发人员特别喜欢把逻辑往下沉。也就是说,大量的业务计算直接写在数据库里。这对应用层来说确实便于,调个存储过程就把活干了。但是这就导致了一个结果,数据库里的T-SQL代极其庞大。
在这个场景下,T-SQL这东西,它有很多自己的专属语法糖。别的数据库都不认。你要换底座,这些语法糖全得敲掉重写。重写不是敲键盘的事,你还得理顺里面的逻辑。有些逻辑连当初写代码的人都离职了,你现在去看那一坨几千行的存储过程,跟看天书一样。改起来极其容易出bug。
1.2 改业务逻辑的风险太大
落到代码里,还有一个很现实的问题。对于企业层级里的应用来说,稳定是第一位的。你改了底层逻辑,哪怕只是换了个函数名,也得重新做全量的回归测试。
从实现思路看,很多项目根本拿不出那么多时间去做测试。他们希望的是,我换个数据库,应用代码一行都不动,或者顶多改个连接串和极个别的语句。如果不能做到“零修改”或者“极少修改”,这项目推下去的阻力就很大。这也是很多传统迁移方案走不通的原因。
二、KES V9R4C019补全的几把硬刷子
理解这一步时,为便于解决上面说的这些痛点,金仓在KES的V9R4C019版本里,狠狠补全了一批SQL Server的核心语法特性。这不是轻松兼容几个关键字的事,而是把T-SQL的那套逻辑给真正实现了。咱们挑几个最常用的硬骨头来看看。
2.1 MERGE语句:一个顶三个的利器
落到代码里,做过数据同步或者做落地方案的兄弟,肯定对MERGE语句不陌生。这东西在SQL Server里用得太广泛了。
结合项目来看,它是干啥的呢?其实就是把INSERT、UPDATE、DELETE这三个操作捏在一块儿。你拿源数据跟目标表去比。如果目标表里有这行,你就更新;如果没有,你就插入;如果目标表里多出了源数据没有的,你还能够删掉。
在SQL Server里,写法是这样的:
MERGE INTO TargetTable AS T
USING SourceTable AS S
ON T.ID = S.ID
WHEN MATCHED THEN
    UPDATE SET T.Col1 = S.Col1
WHEN NOT MATCHED THEN
    INSERT (ID, Col1) VALUES (S.ID, S.Col1);
在这个场景下,你看,这一句多清爽。如果你要在别的只兼容标准SQL的库里面干这个事。你得先写一句UPDATE关联着写。接着再写一句INSERT NOT EXISTS。代翻倍不说,还得跑两遍,性能也受影响。
理解这一步时,KES V9R4C019现在直接兼容MERGE语句了。你原来的存储过程里写了MERGE,拿过来直接跑就行。不用拆开重写逻辑。这省了多少麻烦事。
2.2 OUTPUT子句:改数据还能顺便拿结果的骚操作
落到代码里,这也是T-SQL里特别好用的一招。一般的UPDATE或者DELETE语句,执行完了就给你得到一个影响了多少行的数字。但是有时候,我想知道我刚才删掉的那行数据到底是啥,或者我想把更新前和更新后的值拿出来做记录。
从实现思路看,在别的库里,你可能得先开个事务,SELECT出来,随后再UPDATE,最后COMMIT。很繁琐。
SQL Server用OUTPUT子句一步到位。
DELETE FROM MyTable
OUTPUT deleted.ID, deleted.Name
WHERE Status = 'Expired';
落到代码里,这语句执行的时候,不仅把数据删了,还把删掉的那行数据给你得到出来。就像一个流水线,一边干活一边出货。这里面的 deleted 和 inserted 这两个虚拟表,KES现在也原样兼容了。你用OUTPUT子句拿到的结果集,跟在SQL Server里拿到的完全一样。这种细节语法的兼容,往往最能解决开发的痛点。
2.3 窗口函数与PIVOT/UNPIVOT:报表统计的常客
企业层级里的系统,少不了做报表。做报表就肯定离不开窗口函数和行列转换。
从实现思路看,SQL Server里的窗口函数,比如 ROW_NUMBER() OVER(PARTITION BY ... ORDER BY ...),用来做分组排序取第一条,太常用了。这个KES很早就兼容了。因为PG内核本身就兼容窗口函数,KES只是做了语法的适配。
结合项目来看,但是PIVOT和UNPIVOT就不一样了。这是SQL Server特有的行列转换语法。
从实现思路看,比如你有个竖表记录了各个月份的销售额。你想把它转成横表,一月、二月、三月各成一列。用PIVOT写起来极其轻松。
SELECT *
FROM Sales
PIVOT (SUM(Amount) FOR Month IN ([Jan], [Feb], [Mar])) AS P;
理解这一步时,若在别的库里,你得写一坨带CASE WHEN的SQL,或者自己在外面用代码转。KES V9R4C019现在把PIVOT和UNPIVOT给实现了。那些复杂的报表存储过程,迁过来就不会因为语法不认而报错了。
2.4 并行DML:大数据量操作的速度保障
实际处理时,SQL Server有个特点,就是它在做大表的UPDATE或者INSERT的时候,如果数据量特别大,它会自动走同时行。也就是说,它开好几个线程同时去改数据。这叫并行DML。这在大数据量处理的时候,速度能提升好几倍。
从实现思路看,KES本身是基于PG内核的,PG在同时行查询这块做得不错,但是并行DML这块原来是不行的。只能单线程改。金仓在底层引擎做了增强,兼容了并行DML。当你执行一个大批量的更新操作时,KES也能像SQL Server一样,调动多个CPU核心一起去干活。这就保证了迁移过来后,跑批作业的性能不会拉胯。
三、抠细节:兼容颗粒度到底细到啥程度
理解这一步时,大语法兼容了,这能解决编译报错的问题。但是光能编译过还不行,还得跑出一样的结果。这就得看细节兼容的颗粒度了。KES在这方面扣得特别细。
3.1 LIKE通配符的那些小九九
结合项目来看,我们平时用LIKE做模糊查询,谁不会啊。但是里面有个细节。SQL Server里,下划线 _ 是通配符,代表任意单个字符。百分号 % 代表任意多个字符。
在这个场景下,若我的业务数据里,本身就有一个下划线呢?比如我查名字叫 A_B 的产品。你要是直接写 LIKE 'A_B',在SQL Server里,它会把 _ 当通配符,把 AB、 ACB 全给你查出来。这就不对了。
理解这一步时,SQL Server的做法是用方括号转义。你得写 LIKE 'A[_]B'。这就只查 A_B 了。
在这个场景下,但是PG和别的标准SQL库,不认方括号转义。它们用反斜杠或者ESCAPE子句。如果你的代码里全是 [_] 这种写法,全得改。
在这个场景下,KES V9R4C019在这个细节上,做到了对SQL Server行为的兼容。你写 LIKE 'A[_]B',KES在底层知道你是要转义下划线,而不是去找方括号。它就按这个逻辑去查。这就省了开发人员去全局搜代码改转义符的麻烦。
3.2 TOP N与排序的配合
SQL Server查前几条数据,不用LIMIT。它用TOP N。
SELECT TOP 10 * FROM MyTable ORDER BY CreateDate DESC;
结合项目来看,KES在S模式下,直接接住了TOP N语法。不仅如此,还有一个细节。SQL Server里,如果你用了TOP N,同时又指定了ORDER BY。如果排序字段有重复值,它得到的结果可能不稳定。有时候你加个 WITH TIES,就能把同时列的也查出来。KES对 WITH TIES 也做了兼容。这种跟排序稳定性相关的细节,如果不兼容,前端的分页列表就会少数据。
3.3 临时表与表变量的内部处理
结合项目来看,SQL Server里用临时表特别多。什么 #TempTable、##GlobalTemp。还有表变量 @TableVar。
实际处理时,表变量这东西,在SQL Server里是没有统计信息的。它往往仅仅只是走固定计划。而临时表是有统计信息的。
结合项目来看,KES在内部对这两者做了映射。对于表变量,KES把它当成一种不收集统计信息的特殊内部表来处理。对于临时表,KES实现了跟SQL Server一样的会话级生命周期和自动清理机制。你的存储过程里写了 CREATE TABLE #Temp,过程跑完,这个表就自动没了。不需你手动去DROP。这种行为的对齐,保证了存储过程逻辑的闭环。
四、存量T-SQL代码直接跑的底气在哪
理解这一步时,说了这么多零散的点,你可能会问,KES怎么就能让存量代码直接跑呢?它底层的机制到底是啥?我画了个图,大家看一下T-SQL在KES内部的流转过程。
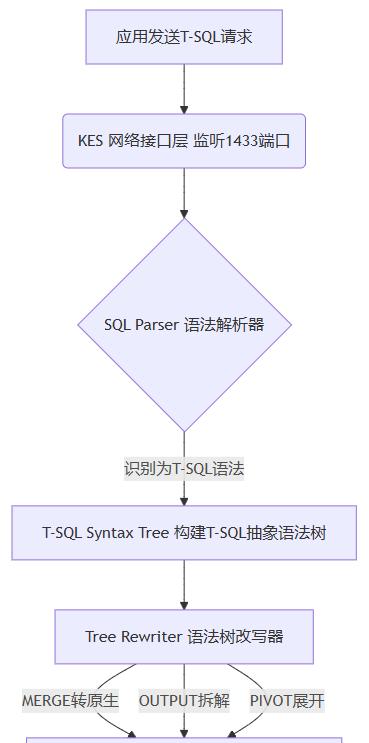
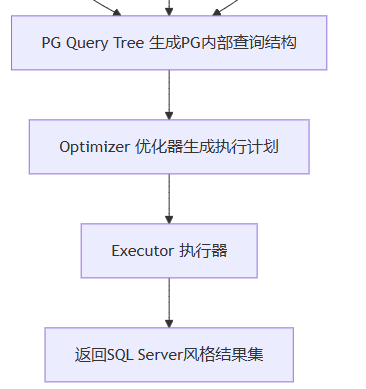
结合项目来看,你看这个流程。应用发过来的T-SQL,首先被KES的S模式解析器接住。解析器不是轻松粗暴地报错说不认识。它会构建出一棵T-SQL专属的语法树。
从实现思路看,接着关键的一步来了,语法树改写器。它会在底层把T-SQL的逻辑,等价转换成PG内核能理解的查询结构。比如你发了MERGE,它给你拆解成PG的UPSERT逻辑。你发了OUTPUT,它给你拆解成带RETURNING的CTE逻辑。
从实现思路看,这种改写是在底层自动完成的。对上层应用完全透明。所以你的应用代码确实不需改。
4.1 流程控制与异常处理
从实现思路看,存储过程里最让人头疼的就是流程控制。 IF...ELSE 嵌套七八层,再来个 WHILE 循环。循环里面如果出错了呢?得用 TRY...CATCH 捕获。
落到代码里,KES现在完全兼容T-SQL的流程控制语法。你写 BEGIN TRY ... END TRY BEGIN CATCH ... END CATCH。如果TRY块里的SQL挂了,流程会自动跳到CATCH块里去。而且在CATCH块里,你能拿到 ERROR_NUMBER()、ERROR_MESSAGE() 这些系统函数的值。这跟在SQL Server里的行为一模一样。
落到代码里,以前这种带异常处理的存储过程,迁移的时候基本得推翻重写。现在直接拿过来编译一下,跑个测试用例,基本就能过了。
4.2 隔离级别与锁提示
理解这一步时,同时发控制也是迁移的一大坎。SQL Server默认的隔离级别是读已提交。但是它有个特点,就是在这个级别下,读操作默认会加共享锁。这跟PG的读已提交是不一样的。PG是不加锁,靠MVCC快照读。
落到代码里,若你的业务逻辑依赖于读操作加锁来防止别的事务修改,那迁到PG下就可能出问题。
从实现思路看,KES在S模式下,对隔离级别的行为做了对齐。它模拟了SQL Server的锁行为。
落到代码里,再一个就是锁提示。SQL Server开发人员最喜欢在SQL里加个 WITH(NOLOCK)。这其实就是脏读,能提高同时发,但可能读到未提交的数据。KES对 NOLOCK 提示也做了兼容。你加了这提示,KES底层就会用对应的快照读机制去处理,不报语法错误,行为也跟SQL Server的脏读对齐。
五、实际改造中的几个注意事项
结合项目来看,虽然KES在语法兼容上做得相当到位了,但是在真实项目中,有些事还是得自己留心。毕竟没有两款数据库能做到百分百行为一致。
5.1 啥S模式是前提
落到代码里,这点我必须强调。KES初始化实例的时候,一定要选S模式。也就是SQL Server兼容模式。如果你选成了PG模式或者Oracle模式,那上面说的MERGE、OUTPUT、TRY…CATCH这些,全都不认。
落到代码里,模式选错了,等于地基打歪了,后面全白搭。我之前带的一个项目,有个新来的兄弟装库的时候手抖选错了模式,后面迁脚本迁得想砸键盘。最后只能把库删了重建。
5.2 遇到极个别不兼容的怎么办
在这个场景下,有些特别偏门的系统存储过程,或者一些跟操作系统强相关的DBCC命令,KES现在确实还没完全覆盖到。这种情况的话,也不要慌。
落到代码里,通常来说,这些偏门语法在你的业务代码里占比极小,可能连1%都不到。对于这部分,你只需稍微手动改一下。比如某个DBCC命令是用来清理缓存的,你能够换成KES对应的系统函数。改完跑个回归测试就行。这比把几千个存储过程全重写一遍,工作量还是小得多。
六、总结几句掏心窝子的话
落到代码里,做数据库替换这活儿,最怕的就是动业务逻辑。逻辑一动,测试无穷无尽。金仓KES V9R4C019这套深度兼容的打法,我觉得路子是对的。
结合项目来看,它不是让你去硬着头皮学新语法,而是主动去适应你原来的老代码。MERGE能跑了,OUTPUT能跑了,TRY…CATCH能跑了,连NOLOCK和方括号转义都认了。这就是在帮你把改造的门槛一点点往下降。
落到代码里,当大部分存量T-SQL代码都能直接跑起来的时候,你就有更多的精力去处理那些极个别真正需改的点。项目推进的阻力自然就小了。对于做SQL Server迁移的兄弟们来说,KES现在的这个兼容度,确实值得一试。搭个环境,把你的存储过程导进去跑一把,你就知道省多少事了。
理解这一步时,总的来说,SQL Server数据库迁移遇到的坑适合结合实际项目边做边理解。先抓住核心思路,再逐步补上细节和边界处理,最后效果会更稳定,也更容易复用。