arcanum-workspace:AI Agent 工具实践指南
作者:互联网 时间: 2026-10-06 11:20:01
实际看arcanum-workspace,先要确认它的用途:AI-第一研究基础设施:HDARP v6.4混合PDF提取、Sraffa 4.0自适应OCR、Hopper Line v2离线本地-GPU提取、 KBIP v1.0 知识库等相关能力。数据与知识处理里,数据结构、更新策略和可追溯性会决定结果是否可信。我会用一份规模可控且答案已知的数据集试跑,检查模式兼容、增量更新、查询结果和来源追踪。它适合需要保留数据来路与变更记录的使用者;采用前仍要看维护状态和试跑结果。
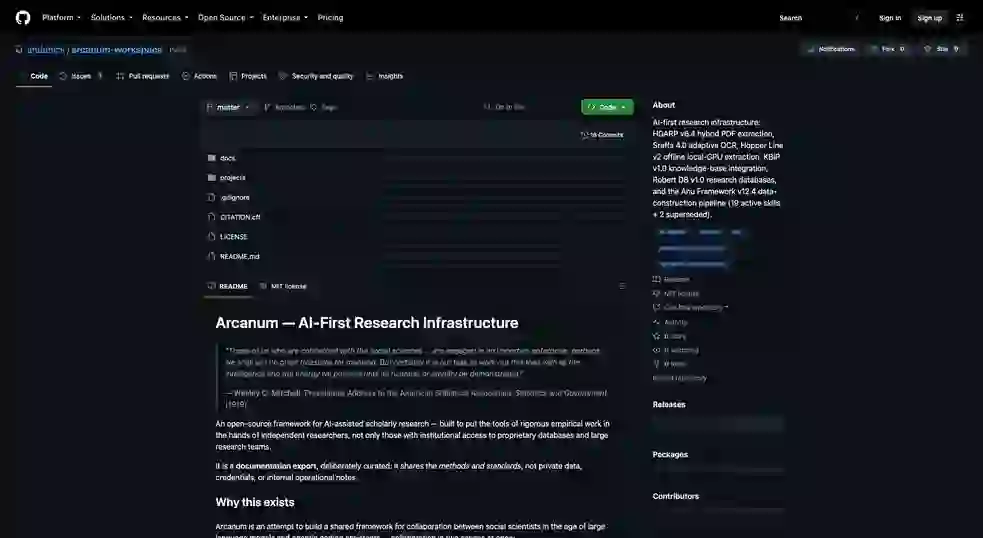
Arcanum — AI-First 研究基础设施
“我们这些关心社会科学的人......正在从事一个不确定的事情 企业;也许我们不会为人类赢得任何伟大的财富。但我们的任务当然是 用我们所拥有的全部智慧和精力来计算出这条线索,直到它变得丰富或 证明无菌性。”
— Wesley C. Mitchell,美国统计协会zhu席致辞, 统计与正府 (1919)
AI- 辅助学术研究的开源框架 - 旨在将严格的工具 实证工作由独立研究人员负责,而不仅仅是那些有机构机会的人 专有数据库和大型研究团队。
这是一个精心策划的文档导出:它共享方法和标准,而不是 私人数据、凭证或内部操作说明。
为什么存在这个
Arcanum 试图为社会科学家之间的合作建立一个共享框架 大型语言模型和代理编码助手的时代——同时具有两种意义的协作:
- 研究人员之间 — 一套通用的方法、标准和出处约定,以便 社会科学家可以在彼此的工作基础上进行构建:提取、数据集和复制包 它们是可互操作的、可审计的和可重用的,而不是一次性的和锁定在单个实验室内的。
- 研究人员与机器之间 — 作为知识分子与 AI 代理合作的模式 合作伙伴而不是黑匣子:代理完成工作,但每一步都保持透明, 经过验证、可重复,并且研究人员可以掌控该方法。
赌注是严格的实证研究工具——长期受许可证保护, 机构准入和大型团队——可以开放,这样单个研究人员就可以工作 与有能力的代理人一起可以达到专业标准并分享结果。
知识传统是特定的,这就是为什么复制在这里被视为引擎 进步,而不是事后的想法:斯拉法花了四十年的时间重建作品并 里卡多的手稿信件;列昂节夫从初级数据中建立了他的投入产出表 人口普查数据;谢赫一系列地重建了古典公共事务经济学的经验学。这些 学者们不仅仅进行理论研究,他们还从各种来源中构建知识,一次一张表。的 忠实的复制是这一发现。
Arcanum 是通过 AI 代理实现大规模此类工作的基础设施。每个 这里的方法已经过实际研究的测试:从苏联统计数据中提取表格 年鉴、战前税收目录数字化、重建数十年的宏观经济数据 分散的正府报告。
里面有什么
| 图层 | 阅读 |
|---|---|
| 文档提取(云代理) | docs/frameworks/hdarp.md — HDARP v6.4 |
| 文档提取(离线GPU) | docs/frameworks/hopper.md — 料斗线 v2 |
| 知识库集成 | docs/frameworks/kbip.md — KBIP v1.0 |
| 每个项目数据库 | docs/frameworks/robert-db.md — 罗伯特 DB v1.0 |
| 数据系列构建 | docs/frameworks/anu.md — Anu 框架 v12.4 |
| 统一的知识架构 | docs/frameworks/auka.md — AUKA v1.1 |
| 代理委员会(谁做什么) | docs/council-tools.md — 17 名活跃成员 |
| 技能+命令模板 | docs/05-commands-skills/ |
关于 HDARP 的注意事项: 公共
hdarp存储库当前提供 v5.1 OCR- 共识层,而此处记录的协议是v6.4(计划发布完整的 v6.4)。
关于 command/skill 模板的注释:
docs/05-commands-skills/发货 可操作的 Runbook 模板,而不是可运行的代码 - 引擎脚本和内部标准 参考不属于此导出的一部分。查看该文件夹的 README。
   PDFs / scans
        │
        ▼
  ┌─────────────┐   cloud-agent reading (HDARP)  ── or ──  offline local-GPU (Hopper)
  │  EXTRACTION │   → body text + tables + equations + figures, with honest provenance
  └─────────────┘
        │
        ▼
  ┌─────────────┐   KBIP — method-agnostic integration (records HOW each document was read)
  │ INTEGRATION │
  └─────────────┘
        │
        ▼
  ┌─────────────┐   Robert DB — one queryable database per project; two-axis quality
  │  DATABASE   │   (source quality × reading fidelity); honest per-field provenance
  └─────────────┘
        │
        ▼
  ┌─────────────┐   Anu — construct reproducible data series (faithful replication + extension,
  │ CONSTRUCTION│   no synthetic data, no proxies, full provenance)
  └─────────────┘
        │
        ▼
   publishable, citable datasets
道德规范
上面的血统不是装饰;这就是方法。一些承诺贯穿一切:
- 复制就是进步。 从源头复制结果对于自动化来说并不是一件苦差事 远离——这就是累积知识的实际构建方式。该管道的设计旨在使 重建和诚实的扩展例程。
- 诚实的不确定性。 “未捕获”、“难以辨认”和“低置信度读取”是一流的 价值观——永远不会默默地空白或猜测。质量是两个轴:源数据是否可靠 与我们是否正确阅读它分开进行跟踪。
- 没有合成数据,没有代理。 如果无法获取值,则将其标记为缺失 - 不是 捏造的,而不是悄悄地换成不同的概念。
- 殴打者,而不是清扫者。(在冯内古特的区分之后。)工作一步一步进行——每一个 在下一个之前进行验证——仅根据真实数据。
- 代理作为合作伙伴,而不是预言机。 AI 代理承担繁重的工作,但每个分析步骤都是 透明、经过验证且可逆——质量来自于细致的验证,而不是来自于 信任黑匣子。研究人员与代理一起进行调查,并对方法负责。
- 公开的方法。严格的经验工具长期以来一直受到许可证的保护, 机构准入和团队。 AI 改变了这个方程式:一名研究人员精心设计 基础设施现在可以满足专业标准。共享该基础设施——制作方法 透明——这本身就是重点。
这就是米切尔位居榜首的原因。定量社会科学是一个“不确定的事业”;没有人 可以承诺一定会有成果。但有责任诚实地构建工具并应用它们 严格地,找出答案——努力工作,直到证明它的丰富性或贫瘠性。
核心原则(可移植到任何工作空间)
- 一条强制性规则: 每个项目都将原始源代码保留在
Inputs文件夹中 (只读);处理发生在其他地方。其他一切都很灵活。 - 出处无处不在——每个系列、表格和图形都记录了它的来源和方式 被导出。
- 机器可以检查的标准 - 版本化协议+自动审核,因此质量得到加强, 不仅仅是希望。
开始使用
git clone https://github.com/andenick/arcanum-workspace.git
- 对于 AI 代理: 阅读
docs/frameworks/中的框架文档,然后docs/05-commands-skills/中的技能模板。 - 对于研究人员: 从
docs/frameworks/中的方法开始,然后 浏览projects/以查看其应用情况。 - 多 LLM: 协议与平台无关 - Claude、Gemini 或任何有能力的 coding/vision 代理。
相关资讯
-
- obot:实践指南
- 2026-10-06
-
- evo:AI Agent 工具实践指南
- 2026-10-06
-
- brooks-lint:AI Agent 工具实践指南
- 2026-10-06
-
- cc-wf-studio:AI Agent 工具实践指南
- 2026-10-06
-
- OpenFigura:AI Agent 工具实践指南
- 2026-10-06
-
- MySQL8 主从同步容器化部署实用指南
- 2026-10-06