Opus 5.5 API 出错怎么办?状态码、限流与容量排查
作者:互联网 时间: 2026-10-30 17:50:01
本文面向 Anthropic 原生 API,其他服务商的错误格式可能不同。
API 调用失败,先别重复点重试。先保存状态码、错误类型、具体信息和请求 ID,再判断是请求本身有问题、账户问题,还是临时服务问题。不同原因需要不同处理方法。
同样是“用不了”,参数写错、额度耗尽和服务过载,重试效果完全不同。
一、先保存哪些信息?
建议记录发生时间、模型名称、HTTP 状态码、错误类型、错误说明和请求 ID。再记录输入大致大小、是否流式、是否开快速模式,以及最近改了什么参数。
日志中不要写入真实密钥,也不要默认保存完整敏感材料。需要排查内容时,先做适合分享的简化样例。
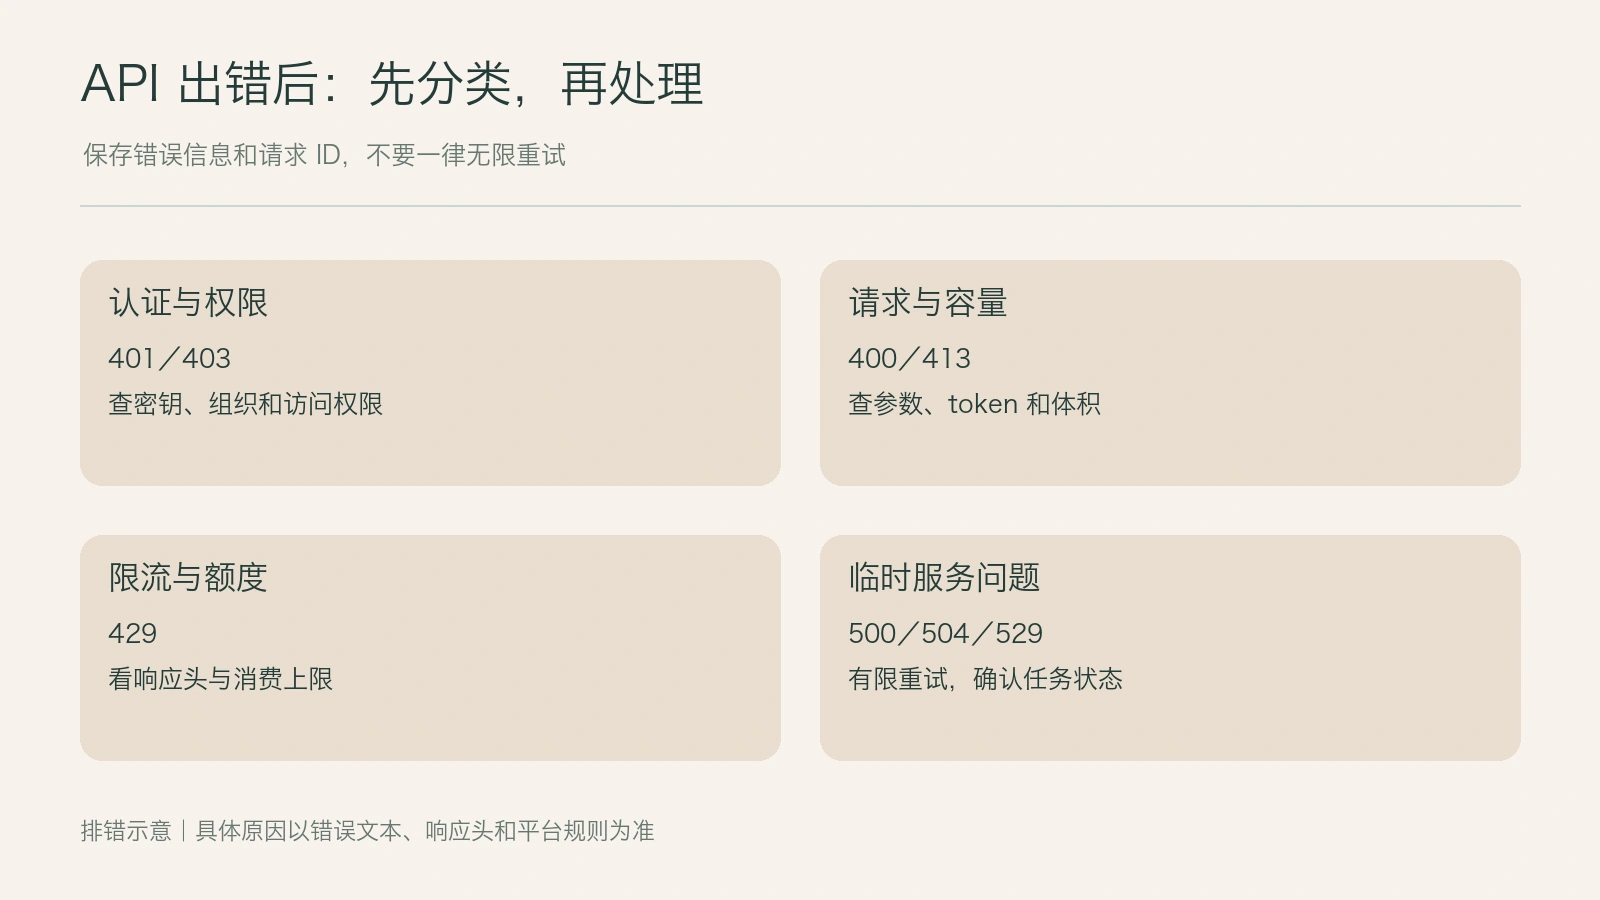
图:先分类,再处理;参数和账户问题不要靠无限重试解决。
二、常见状态码怎么处理?
| 状态码 | 常见含义 | 优先检查什么 |
|---|---|---|
| 400 | 请求参数、内容或部分消费限制问题 | 具体错误文本、模型规则、消费上限 |
| 401 | 认证失败 | 密钥是否有效、环境是否正确 |
| 402 | 或付款问题 | Console 状态 |
| 403 | 没有资源权限 | 组织、工作区和模型访问权限 |
| 404 | 资源不存在 | 地址、模型与资源 ID |
| 413 | 请求字节数过大 | 文件、图片和整个请求体积 |
| 429 | 限流或某类额度上限 | 响应头、消费限制和请求速度 |
| 500/529 | 内部错误或暂时过载 | 有限重试,保存请求 ID |
| 504 | 处理超时 | 请求长度、流式方式和超时设置 |
一个状态码可能对应不止一种原因,表格只是检查入口,最终仍看具体报错。
三、400:先退回最小请求
把请求缩小到一个模型、一个短问题、合理的输出上限。删除暂时不需要的工具、文件和测试参数,确认最小请求能否成功。
Opus 5.5 不接受关闭思考和旧式手动思考预算;强制工具调用的部分设置也不支持。旧程序只改模型名称,可能在这里出错。
如果错误明确指向消费上限,就去查看组织或工作区预算。不要把所有 400 都当成代码语法问题。
最小请求成功后,再一次加回一个功能。记录从哪一步开始失败,比检查一个很大的 JSON 更方便。
四、401、403、404:分别检查认证、权限和名称
401 先核实当前进程读到了正确的密钥,但不要把密钥打印出来。终端、编辑器和后台服务的环境变量可能不同。
403 说明请求可能已经带上认证,却不被允许使用目标资源。检查当前组织、工作区及模型开放情况,而不是立即创建更多密钥。
404 先核对端点和资源标识。原生 Claude API、Bedrock 和其他云平台的模型名称与认证方式可能不同,不能混用。
五、429 不一定等几秒就恢复
请求或 token 限流时,可以参考 retry-after 响应头,降低并发,等待后再试。批量工作应使用队列控制速度,不要让所有任务同时循环重试。
但 429 也可能来自月消费档位上限,或特定工作区消费限制。某些消费上限类响应没有 retry-after,在额度状态变化前持续重试没有用。
Fast Mode 还有独立限流。快速通道限流,并不表示标准通道一定不可用;是否降回标准速度,应由应用明确设置和记录,避免用户不知道发生了什么。
六、上下文超限与 413 不是一回事
上下文超限主要看 token 总容量。系统要求、历史消息、工具结果、图片和本轮生成空间都会影响它。
处理时先计数,删除无关历史和冗长日志,再按主题拆分材料,给输出留空间。只提高 max_tokens 可能让容量问题更严重。
413 则是请求字节数超过允许大小。即使 token 没到上限,体积过大的编码图片或文件也可能触发。应减少请求体积、按支持方式上传,或分批处理。
原生接口与第三方平台的体积限制可能不同,错误来自哪一层也要确认。
七、临时错误怎样重试?
对网络连接问题、部分限流和临时服务错误,可以采用逐渐延长间隔、带少量随机等待的有限重试。SDK 本身可能已经自动重试,程序外层不要再叠加无限循环。
下面是读取异常信息的简化示例;在自己的环境中运行时会发起真实请求,可能产生费用。
import anthropic

try:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=4096,
        messages=[{"role": "user", "content": "说明本次处理结果"}],
    )
except anthropic.RateLimitError as error:
    print("检查限流与消费上限:", error.status_code)
except anthropic.APIStatusError as error:
    print("status:", error.status_code)
    print("request_id:", error.request_id)
except anthropic.APIConnectionError:
    print("检查连接与超时设置")
这里假设已创建 client。正式程序还应保留可恢复的任务状态,并按错误类别决定重试或停止。
八、已经返回一部分文字,又失败了怎么办?
流式连接可能在输出途中出现错误。不要只要收到第一段文字就把任务标成成功;应等待最终状态,记录是否完整。
如果模型已经调用外部工具,更要先检查操作结果。例如创建文件可能成功,而后续回应失败。重做前先查文件是否存在,避免重复操作。
回答因 max_tokens 截断,与 HTTP 请求失败也不同。前者要检查生成预算和分段方案,不一定需要重发完整任务。
九、提交给支持前,准备一个最小复现
保留时间、请求 ID、模型、SDK 版本、错误文本,以及删去敏感信息后的最小请求。说明是否每次发生、何时开始、最近改了哪些设置。
一次只改一个条件进行测试。先判断错误属于哪一类,再改对应配置,往往比反复更换模型和增加输出上限更快。