扫描PDF如何转成可编辑PPT?从OCR到导出与核对
作者:互联网 时间: 2026-11-06 19:20:01
纸质资料扫描成 PDF 后,字往往只是图像的一部分。用 Acrobat Pro 给页面添加可复制的文字层,再转成 PPTX,最后在 PowerPoint 中确认文字是否落在独立文本框中。
识别扫描页里的文字
保留原扫描件,用 Windows 或 macOS 上的 Acrobat Pro 桌面版打开副本。在新版界面中,进入「所有工具」→「扫描和 OCR」,在识别文本区域选择「在此文件中」。先挑一张文字、表格都有的代表页试识别,确认页码范围和文档语言,再点「识别文本」。简体中文扫描件应选相应语言,避免沿用英文设置。
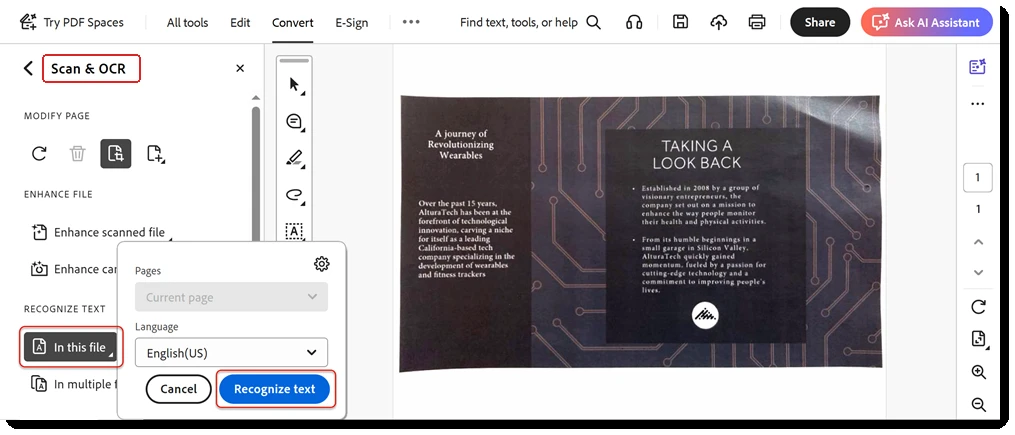
识别完成后保存 PDF 副本。可用标题中的词做一次搜索,检查文字层是否可用。留意竖排、双栏和表格中的阅读顺序,特别是小数点、百分号及编号。斜拍或低清页面如果错字多,可先换清楚的扫描件,再做整份识别。
上传识别后的副本
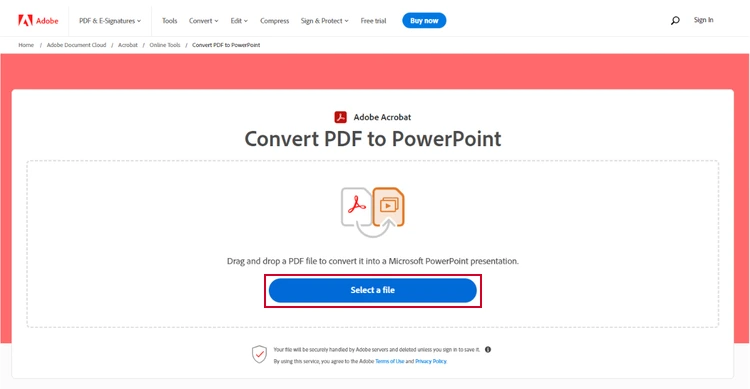
打开 Acrobat 网页版的「PDF 转 PPT」工具,点「选择文件」,上传刚保存的识别版 PDF。网页端需要上传文件,遇到账号或上传限制按当页提示处理。
下载转换结果
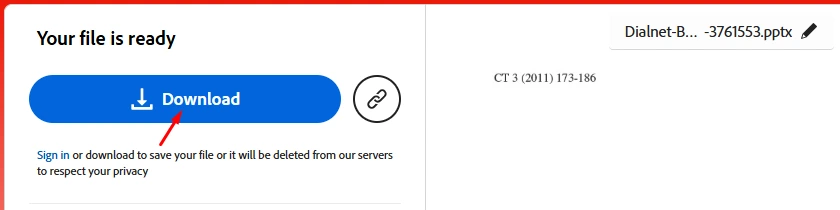
转换完成后,在结果页点击「下载」,保存 .pptx 文件。页面可能因账户状态而显示登录提示。检查下载的文件扩展名,再用桌面版 PowerPoint 打开。
检查幻灯片中的文字对象
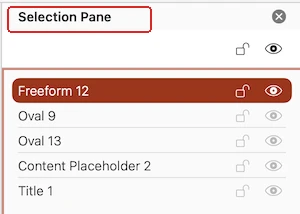
在 Microsoft 365 或 PowerPoint 2024 桌面版打开转换结果。从「开始」选项卡的「选择」或「排列」菜单打开「选择窗格」,菜单位置随平台和版本变化。查看标题和正文能否单独选中,再点击文字确认能放入光标。整页随一张图片选中时,可从识别后的 PDF 复制校对过的字句,重新做成幻灯片文本框。
整理时优先核对标题、数字和单位。图表若只有扫描画面,图里的数字仍可经 OCR 提取和校对,但要改系列数据或坐标轴,就需要在 PPT 中重建图表。只需改正文时,可以保留图表图片,再把要修改的文字做成独立文本框。