多智能体比单智能体贵多少?按调用量算一笔账
作者:互联网 时间: 2026-11-07 11:10:01
同一张客服工单,在下文的假设里由单角色处理需 0.009 美元,由多个角色协作需 0.018 美元。示例差额为 0.009 美元,实际随资料长度和模型调用次数变化。
先对齐模型单价和计费单位
假设两种流程都根据同一份客服工单和资料生成一份答复,都使用 GPT-5.4 mini 的标准文本 API。每百万未缓存输入 Token 为 0.75 美元,每百万输出 Token 为 4.50 美元。为便于比较,先假设缓存命中为零,也没有额外的搜索、工具、重试和人工费用。下列 Token 数是演算假设。
单智能体把资料放在同一次调用中,计费输入 6,000 Token,计费输出 1,000 Token,费用为 6,000 × 0.75 ÷ 1,000,000 + 1,000 × 4.50 ÷ 1,000,000 = 0.009 美元。
多智能体由主角色分派,专职角色各自读资料并回传结果,主角色再写答复。各次调用合计计费输入 12,000 Token、计费输出 2,000 Token,费用为 0.018 美元。中间结果在生成时计入输出,再被主角色读取时也占用输入。若两套流程各完成 1,000 单且用量都与示例相同,模型费用分别为 9 美元和 18 美元。
工作流套餐和模型调用分开算
在 n8n 工作流画布里,AI Agent Tool 节点可以接到主 AI Agent 的工具连接口。图中、技术和账户角色是主智能体可按需调用的分支。仅触发其中一条分支,与逐个调用全部角色,产生的模型用量会不同。
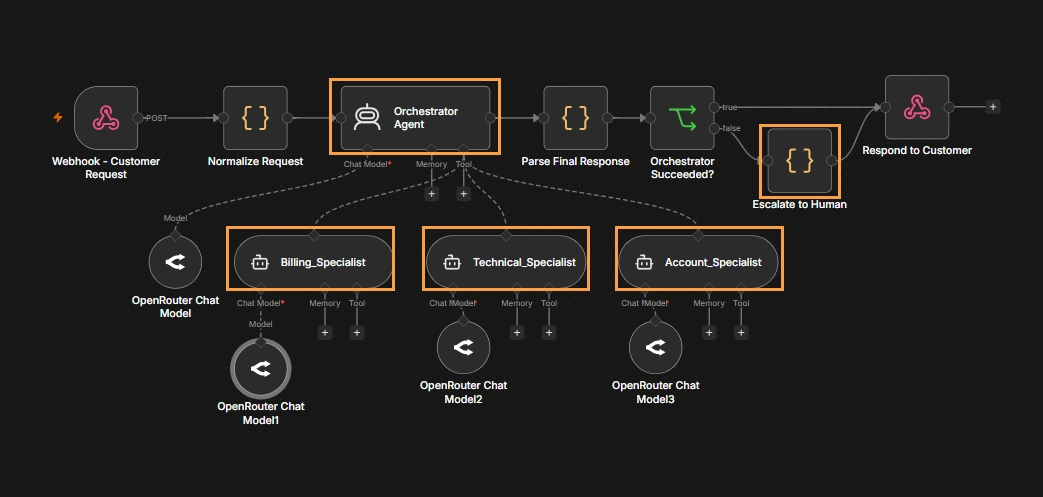
n8n 的社区版可免费自部署,服务器和维护由使用者承担,社区版缺少项目和工作流共享功能。托管版提供免费试用,Starter 年付折合每月 20 欧元,包含每月 2,500 次工作流执行。工作流执行额度按运行计,一次执行中的模型调用可有多次。采用自行配置的外部模型 API 时,按供应方的用量和单价另计。
以通过验收的任务为单位
比较时固定工单和验收条件,再把模型、工具、平台和人工开支相加。失败和重跑也会花钱,最终用总开支除以验收通过的工单数。
并行可以缩短互不依赖的分支所需的等待时间,费用仍要合计各分支的实际用量。把完整工单只交给需要它的角色,其他角色只读必要字段,有助于减少重复输入。如果分工能降低返工或人工审核的成本,把这些节省额也计入比较。