平时做技术实践时,很多问题不是概念不会,而是细节没串起来。拿“nodejs个人博客开发第六步 数据分页”来说,它看着像小点,放到项目里常会牵出环境、配置、兼容性和维护成本。下面按实际采用顺序,把思路、关键写法和容易踩坑的地方讲清楚,便于大家直接对照操作。
本文为大家分享了nodejs个人博客开发的数据分页,具体内容如下所示
控制器路由定义
首页路由:(链接已移除)
首页分页路由:(链接已移除)
/**
* 首页控制器
*/
var router=express.Router();
/*每页条数*/
var pageSize=4;
/*首页*/
router.get('/',function(req,res,next){
 var cid=0;
 F.model("article").assignIndexData(cid,1,pageSize,res);
});
/*首页分页*/
router.get('/index/:page',function(req,res,next){
 var currentPage=parseInt(req.params.page);
 var cid=0;
 F.model("article").assignIndexData(cid,currentPage,pageSize,res);
});
分类列表分页路由:(链接已移除)
/*分类页*/
router.get('/category/:cid/:page',function(req,res,next){
 var cid=req.params.cid;
 var currentPage=parseInt(req.params.page);
 F.model("article").assignIndexData(cid,currentPage,pageSize,res);
});
模型数据部分
结合项目来看,控制器调用article模型的assignIndexData()方法,参数:分类id,当前页,每页条数,响应对象
在这个场景下,调用category模型的getAllList()方法得到分类list,参数:回调函数
落到代码里,调用article模型的getCount()方法得到总条数,参数:分类id,回调函数
在这个场景下,调用article模型的getArticlePager()方法得到文章对象的数据list,参数:分类id,当前页,每页条数,回调函数
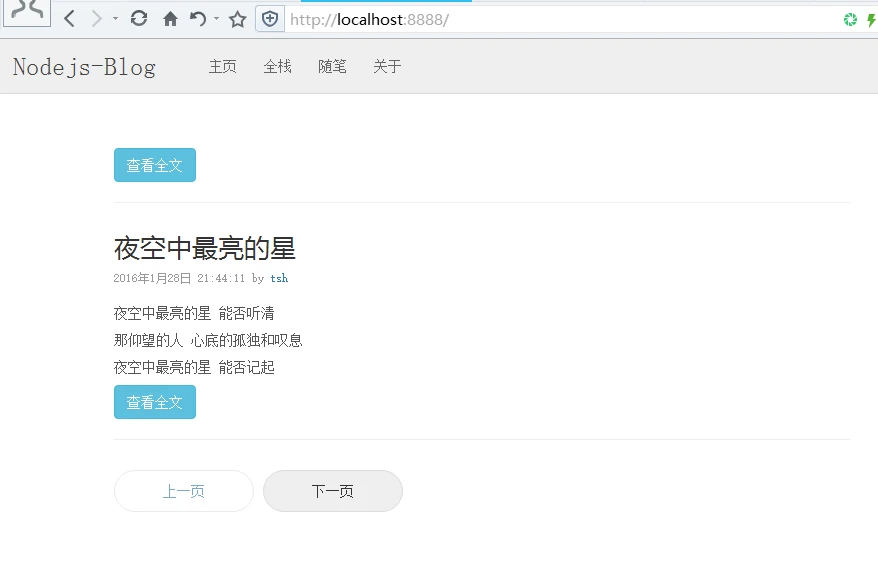
结合项目来看,对上一页,下一页进行-1和+1,同时进行判断,上一页应大于0,下一页应小于等于总页数(总条数/每页条数 向上取整)
把数据分配到模板上
/**
* 文章模型文件
*/
module.exports={
 /*获取条数*/
 getCount:function(categoryId,callback){
  var condition="";
  if(categoryId!=0){
   condition="where category_id="+categoryId;
  }
  var sql="select count(*) num from article "+condition;
  db.query(sql,callback);
 },
 /*获取分页数据*/
 getArticlePager:function(categoryId,currentPage,pageSize,callback){
  if(currentPage<=0||!currentPage) currentPage=1;
  var start=(currentPage-1)*pageSize;
  var end=pageSize;
  var condition="";
  if(categoryId!=0){
   condition="where category_id="+categoryId;
  }
  var sql="select * from article "+condition+" order by time desc limit "+start+","+end;
  db.query(sql,callback);
 },
 /*归档*/
 getArchives:function(callback){
  db.query("select time from article order by time desc",callback);
 },
 /*分配首页数据*/
 assignIndexData:function(cid,currentPage,pageSize,res){
  var categoryModel=F.model("category");
  var articleModel=this;
  // 分类数据
  categoryModel.getAllList(function(err,categoryList){
   // 文章条数
   articleModel.getCount(cid,function(err,nums){
    // 文章分页
    articleModel.getArticlePager(cid,currentPage,pageSize,function(err,articleList){
     var nextPage=(currentPage+1)>=Math.ceil(nums[0].num/pageSize) ? Math.ceil(nums[0].num/pageSize) : currentPage+1;
     var prePage=(currentPage-1)<=0 ? 1 : currentPage-1;
     // 归档
     articleModel.getArchives(function(err,allArticleTime){
      var newArticleTime=[];
      for(var i=0;i<allArticleTime.length;i++){
       newArticleTime.push(F.phpDate("y年m月",allArticleTime[i].time));
      }
      /*分配数据*/
      var data={
       categoryList:categoryList,
       articleList:articleList,
       cid:cid,
       nextPage:nextPage==0 ? 1 : nextPage,
       prePage:prePage,
       allArticleTime:newArticleTime,
       currentPage:currentPage
      };

      /*渲染模板*/
      res.render("home/index",data);
     });
    });
   });

  });
 }
};
模板部分
<nav>
   <ul class="pager">
    <li><a class="btn <%if(currentPage==prePage){%>disabled<%}%>"
    href="/<%if(cid!=0){%>category/<%=cid%>/<%}else{%>index/<%}%><%=prePage%>" rel="external nofollow" >上一页</a></li>
    <li><a class="btn <%if(currentPage==nextPage){%>disabled<%}%>"
    href="/<%if(cid!=0){%>category/<%=cid%>/<%}else{%>index/<%}%><%=nextPage%>" rel="external nofollow" >下一页</a></li>
   </ul>
   </nav>
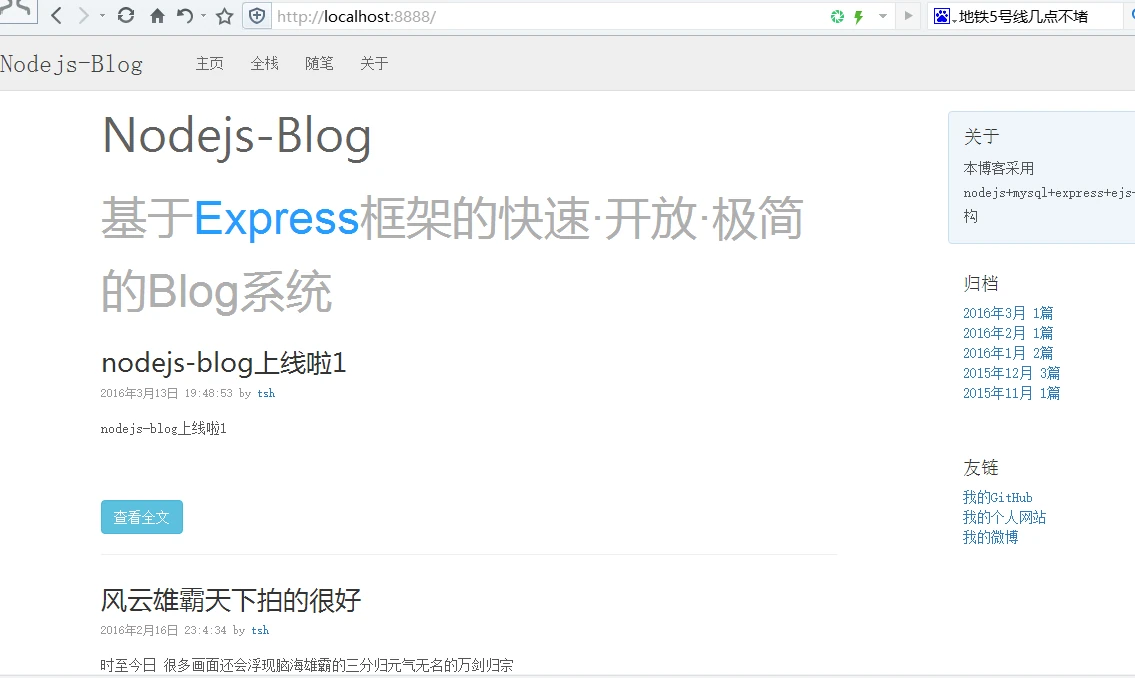
效果图:
在这个场景下,整体来看,nodejs的关键在于理解执行流程和资源边界。把错误处理、性能开销和业务场景一起考虑,方案落地时会更稳。