ai-flavor-less:实践指南
作者:互联网 时间: 2026-10-03 09:40:02
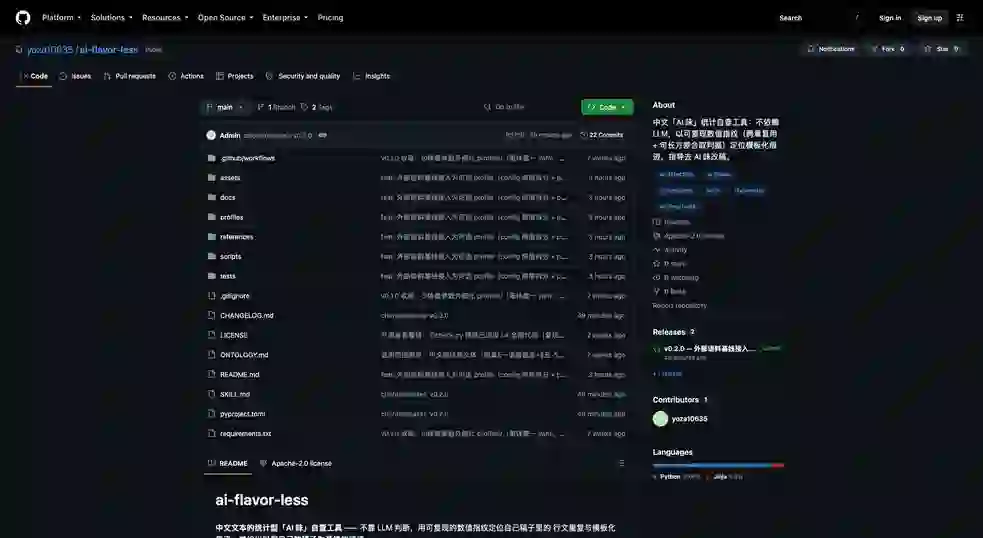
实际看ai-flavor-less,先要确认它的用途:中文「AI 味」统计自查工具:不依赖 LLM,以可复现数值指纹(跨章复用 + 句长方差合取判据)定位模板化痕迹,指导去 AI 味改稿。日常自动化里,输入边界、依赖和失败处理如果不清楚就很难稳定复用。我会用一项范围明确的真实任务完成最小试跑,检查配置时间、输出质量、异常信息和维护痕迹。它适合愿意先做小范围验证并复查原始文档的团队;采用前仍要看维护状态和试跑结果。
名称:无艾味 描述:对中文现代散文(小说/散文/报告)做统计型 AI 味检测:六层指纹 + 跨章复用 + 蒸发据,抽取 LLM,支持轴线架构与六档档案(通用/网文/论文 + 新闻/乎知/学术外部语流程图);结果用于指导 AI诗歌/文言不适用。触发:AI 味、句式指纹、行文重复、车轱转动话、文风检测、去 AI 味、审稿、改稿。 代理创建:真
句式指纹检测(ai-flavor-less)
宪章 →
ONTOLOGY.md(核心本体论) 任何检测层、阈值、轮廓、输出格式的增删改,必须先关联: AI 味 = 人类读者主观可感知的差异;成因是目的性导向写作; 判据是统计特征的合取——现行 = ①出现频率 + ②标准化方差 的 2/2 制; ③信息密度为开放项(现象成立、句对级操作化已证伪退役,宪章 §3.4)。 与之冲突的实现一律视为待修缺陷。
中文 Markdown/文本章节做统计型「AI 味」检测:不靠 LLM 判断,用可复现的数值指纹定位行文重复与模板化轨迹。双重架构——统计核心(跨文体通用)+文体简介(通用/网文两套规则)对。
适用范围:中文现代散文体(小说/散文/报告/说明文)。 诗歌与文言/半文言不适用:句长恒定、对仗复现、重韵律是那些体裁的形式本体 (近体诗 CV 恒低、对战斗会触发重复旗)——会被系统性误判输出,无效(宪章§一/§五-5)。
当前状态(与宪章的差距)
- ①出现频率:已实现 ——
--cross-chapter跨章装置报告(结尾段字符4-gram,DF≥3 提示 / ≥5 flag,定位型)- ②标准化纬度:已实现 —— L3判据为章级 CV=σ/mean(
cv_thresh,高→关注);σ仅显示,不作判据- ③信息密度:已退役 —— 40 对盲判复核精确率 7.5%,句对级不存在车轱辘话签名; 实现已从代码删除(复现走 git 历史 v1.2),证据链见
references/indicator-3-falsification.md- 合取判据为 2/2 制(①+②,宪章 §3.2);工具侧超标计数输出格式未实现
- L0句内部结构按宪章降级为必性层,应与AI 味分栏输出报告(分栏待做)
- L1.5 规范清单为时敏层,结论只作提示,不进合取判据
请参阅
ONTOLOGY.md§3.1(指标)与 §3.3(六层重新定性);CV 公式与 n-gram 构成参考 lmscan v0.6.1(Apache-2.0)并关联于代码注释。
依赖
首次运行前检查并安装Python依赖(分发包内含requirements.txt时优先用它):
pip install -r requirements.txt
# 包内无 requirements.txt 时的等价命令:
pip install jieba jinja2 pyyaml
使用方式
检测脚本为 scripts/check.py,报告模板为 assets/report_template.md.j2(脚本自动按 asset/ → scripts/ → 当前目录顺序定位,需手工指定)。
检测章节
python scripts/check.py [--profile=通用|网文|论文|新闻|知乎|学术] [--out-dir=报告目录] 文件 [文件 ...]
支持格式:.md / .txt / 无扩展名文本 / .docx(编码自动回退,见"注意")。
--profile=通用(默认):只做统计核心 + 文本内相对异常判断,不判违禁词/对话标签/系统数据行,适合论文、非网文文本。--profile=网文:叠加创作规范规则(违禁词、情绪直写、对话标签占比、系统数据行、破折号/'的'密度绝对阈值)。--profile=新闻|知乎|学术:外部语料基线(各自 5 篇、见references/external-corpus-summary.csv)。用来回答"这篇稿是否偏离该体裁的统计形态",阈值取均值 + 2σ。它们不是 AI 味判决——尤其学术体,其描述层(信息停滞/词性堆叠/模板)大面积触发是体裁惯例,故该 profile 故意把这几项留null(见profiles/学术.yaml顶部说明与宪章§5重力)。--out-dir:报告输出目录,默认<当前目录>/reports/。每章产出<章节名>_指纹报告_<profile>.md;多文件时结尾输出跨章汇总对比表。
两类开关不要混(2026-09拆分,外部基线概况的前提):
| 层 | 管什么 | 由谁开关 |
|---|---|---|
| 数值阈值层 | 章CV / 破折号 / '的'密度 / 对话标签 / 3-4句段 / 精彩 / 节日信息 / 排比簇 / 模板 | 逐项独立,填了阈值即生效,null = 不判该项 |
| 文体清单层 | 违禁词 / 情绪直写 / 系统数据行(时敏层,只作提示) | 单个 banlist 开关 |
拆分前数值阈值全被 banlist 罩着,导致 banlist: false 的体裁(外部基线全是)即使填了阈值也不生效——这是接外部基线时发现的旧缺陷。现两套解耦:banlist: false 不等于"不做任何判定"。
基线校准
用已评审通过的章节作为基线,统计各指标均值±2σ,输出建议阈值:
python scripts/check.py --calibrate 基线1.md 基线2.md ...
计算结果只打印不自动写回,构成附可直接粘贴的yaml片段。人工确认后存为profiles/<体裁名>.yaml(每体裁一个文件,任意键=配置文件名,只写差异项,其余继承"通用"部分)即可覆盖里面默认阈值;旧版单文件profiles.yaml仍兼容(当前工作目录→技能根目录→脚本/顺序替换)。格式与加载规则见references/profiles.example.yaml。
外部语料基线(新闻/知乎/学术)
仓库自带三份现成基线,无需校准即可当参照系:
| 简介 | 语料 | 数据 |
|---|---|---|
新闻 |
澎湃新闻 5 篇(约 4.8 千汉字) | references/external-corpus-summary.csv |
知乎 |
知乎日报署名作者 5 篇(约 1.5 万汉字) | 同上 |
学术 |
汉斯出版社 OA 论文 5 篇(约 3 万汉字) | 同上 |
python scripts/check.py --profile=知乎 待检稿.md
两条使用纪律:
- 它回答是“不像这个体裁”,不是“不像AI”。每条阈值都是“均值+2σ”,且n=5,
σ不稳定(新闻的
rep_ratio就被单篇新闻1从0抬到0.209)。超出只说明结束该体裁的实测范围。 - 学术简介创造关掉大半描述层。该体裁的“信息营销/创意性/模板命中”是新闻/知乎的3-10倍,
按宪章Q2属体裁宽度AI味,照搬动阈值将正常纸张成片误判别。可迁移的只有章级CV
(跨体裁测试结论 3:六层中唯一无需换标定即可比)。要判学术文本的 AI 味,仍须
--calibrate自己的批次。
阈值不跨语料迁移(宪章 §六)。外部基线与你自己的
--calibrate结果可以并存, 但别用同一个阈值去判两件事。
补充检测:句法框架、判断句先行与对话感
scripts/check_frame_repeat.py 补 check.py 测不到的几层。以下盲区均已核实到代码行号,不是推测:
| 盲区 | 原因 | 对应指标 |
|---|---|---|
| 「短判断句 + 提示标点 + 展开」这个跨句骨架反复复现 | L2只比对实词序列(重构去掉结构助词与停顿标点,见check.py:67、:566);这一族实词完全不同,只有标句点与虚词相同,所以永远报“无重复主题簇” |
指标A、指标B1 |
| 以句号收尾的判断句先行(如"轻的那条路可以直接排除。") | 原判据只认提示标点(:/——),句号收尾的同类病灶漏网——病灶是"先抛判断、再补注解",与末尾标点无关 | 指标B2 |
| 聚合列只统计"破折号每千字"、不统计冒号 | 中文里冒号与破折号在"提示下文/解释"上语义等价 → 把破折号换成冒号能让那一栏归零,而句法框架一处未动("标点迁移"型伪修正即由此骗过工具) | 指标A(两类合并计) |
| 对话体标记 | check.py 有"问号"一栏但只展示;第二人称、祈使、口语连接、元叙述全不数 |
指标D(八类) |
python scripts/check_frame_repeat.py 文件.md [--max-pred=18] [--min-frame=4]
python scripts/check_draft_stats.py 文件.md   # 体量与节奏:汉字/含标点数、分句粒度段内CV与pooled CV、标点计数、'的'密度三口径
改稿必看的第三组数(check_draft_stats.py):check.py 给章节级指纹、check_frame_repeat.py 给句法框架,但改稿每轮要手算的字数与节奏两者都不直接给——尤其是分句粒度的段内 CV(check.py 的"段内均值 CV"是句群粒度,而改稿是逐句改的,只有分句粒度能反映改动效果)与 pooled CV。
分母陷阱(实测):'的'密度有多个分母。
check.py的报值是"段落拼接口径"(n_chars= 逐段拼接后的长度,剔除段落间空行、段内字符原样保留),知乎 5 篇基线 3.22% 同源(来自references/external-corpus-summary.csv的的密度_%列,逐篇可核);含空白口径比它略低(约 0.05pp),汉字分母会算出约 4.5%,看起来像"远超基线",其实只是分母换了——混用会得出方向相反的结论。判读时先认①段落拼接栏,且比较双方必须同分母。
性质声明:这是结构性自查工具,不是判据。指标 A/B 的阈值来自单篇稿子的前后对照,没有真实语料基线(skill 的 CSV 只提供破折号基线 0.31/千字,冒号与"判断句先行"两项无基线可依)。正确用法是同一篇改前改后对照,或与同体裁文本横向比,不可当跨体裁的绝对门槛。
指标 B2 输出的是候选清单,不是判决——首句摘要位(承担标题职能)、对仗收口、事实陈述之后的落点句,都是合理的判断句先行,需人工判读。判据已加三条过滤(长度 6–18、须含判断标记、须无数字与专名)以压掉状语片段类误报;实测未过滤 25 处 → 过滤后 8 处。
改稿顺序(实测踩过坑,务必照做):先定文体(陈述体/对话体)→ 再消跨句骨架重复 → 最后才看标点密度。反过来做(先清破折号)会得到"指标全绿但毛病一处没动"的假达标。
另一类病灶:研报味(六层指纹测不到)
"研报味"是"目的性导向写作"的极端形态(信息传递效率最大化、零闲笔、无起伏),因此落在宪章框架内;但它不触发六层指纹——check.py 全绿也可能是满篇研报味。三层可操作表征:
| 层 | 表征 | 量化手段 |
|---|---|---|
| 术语 | 把日常事说成领域语言("累计净利""经调整 EBITA""止损上限""成本曲线") | 无工具,逐句人工扫 |
| 信息密度 | 一句话塞多个数字/专名,不给读者喘气点 | 数每句的数字个数 |
| 节奏 | 句长均匀 —— 正是宪章第二判据(标准化方差)在段内尺度上的表现(L3 看的是章间尺度) | 按 。;!? 切句算 CV = σ/mean,与同体裁基线比(本 skill 语料约 0.44 下沿) |
改法三条,按性价比排序:
- 术语降级(零风险):账本/净赚/盖机房 ← 累计净利/净利润/基建
- 长句拆短(拉 CV 的主力):一句 70 字拆成 8+25+37,制造长短落差
- 一句大白话判断:补人味,但见下方陷阱
⚠ 陷阱(实测踩到过;这里曾发生过一次概念错误,已修正):修研报味时容易顺手加虚词制造松弛,但必须先分清加的是哪一类——
| 加的东西 | 归哪 | 能不能加 |
|---|---|---|
| 口语插入语("说白了")、日常词("净赚""账本") | 指标 E | ✅ 正是松弛的正当来源 |
| 设问/第二人称/元叙述("你看""读者或许会问") | 指标 D | ❌ 一加就是 AI 八股 |
| 议论垫词("其实""也就是说""换句话说") | 指标 E | ⚠ 它们不是口语(书面得很),只按"是否多余"判断 |
语域(书面↔口语)与修辞姿态(陈述体↔伪对话)是两个正交维度: 可以口语化而毫无对话感("米哈游只公开过一次账本"=口语+陈述体); 也可以很书面而充满对话感("读者或许会问,钱够吗"=书面+伪对话)。
松弛来自语域下沉与信息姿态放松,从来不来自对话感。"去 AI 味"砍对话感是对的,但不该顺带砍语域——两者是不同方向的手段,混为一谈会写出"全绿但紧"的稿子。
六层检测速览
| 层 | 检测什么 | 典型 AI 味信号 |
|---|---|---|
| L0 句内结构 | '的'连续链、顿号并列、词性堆叠、'是…的'句 | '的'链 ≥3 = 长定语堆叠 |
| L0.5 模板标点 | 句式模板词对("不是…是"等 21 组)复现 + 标点密度(次/千字) | 同一模板词对高频复现 |
| L1 词层 | 滚动窗口新信息率、句首/句末词分布、高频 3-gram | 新实词 <12% = 原地打转 |
| L1.5 规范清单 | 违禁词、情绪直写("心中…涌上一阵X")、对话标签占比、系统数据行 | 仅网文 profile 启用 |
| L2 句法层 | POS 骨架指纹全文倒排 | 重复骨架簇、相邻 ≥3 句同骨架的排比簇 |
| L3 节奏层 | 章级句长 CV=σ/mean(指标②)、段内 MSSD、短句占比 | CV 偏高 = 句长方差漂移(σ 仅展示) |
跨章装置(指标①)
多章一次性检测「结尾段复用同一套收尾装置」——宪章三指标中①「出现频率」的落地:
python scripts/check.py --cross-chapter 章节1.md 章节2.md ... # 或传目录 glob
输出 reports/跨章装置报告.md:字符 4-gram → 跨章文档频率 DF≥3 提示 / ≥5 flag,附每章牵连度排序(定位改哪章优先)。实测全书 76 章复现「合上本子×11」等装置簇,AUC 0.718★(全部指标最高)。规格见 references/cross-chapter-phrase-cloud.md。
各层指标细节、报告各节对应的数据结构、阈值语义与归因互斥规则(如"顿号并列的'的'不算长定语 AI 味"),见 references/detection-layers.md。
工作流
- 确认 profile:网文/小说用
网文,论文/报告类用通用;想拿外部语料当参照系时用新闻/知乎/学术。不确定时问用户,默认通用。 - 先试跑单章:
python scripts/check.py --profile=<profile> 章节.md,确认报告生成正常(缺依赖先装)。 - 批量 + 汇总:对全书/多章一次性传入,利用结尾汇总对比表定位问题最重的章节。
- 读报告出结论:向用户汇报时优先讲 flags 汇总行与重复骨架簇示例(这是修改抓手),逐条 L0 命中作为证据引用,不要把整份报告贴给用户。
- 阈值不满意时校准:拿已通过的基线章节跑
--calibrate,把末尾输出的 yaml 片段确认后存为profiles/<体裁名>.yaml,复跑即生效。
注意
- 支持格式:
.md/.txt/ 无扩展名文本 /.docx。纯文本编码按 utf-8 → gbk → latin-1 自动回退(GBK 编码的 txt 可直接传)。docx 仅读正文(表格行合并为段,页眉页脚/批注/脚注不统计)。 - 半角标点会被自动归一化为全角;md 的
#标题行、>引用行、分隔线不进入统计。 - jieba 首次标注较慢,长文本属正常;同一句子的标注有 TokCache 缓存,L0/L1/L2 共享。
- 检测是统计信号不是定论:flags 多 = 疑似 AI 味,需结合上下文判断;通用 profile 下长链'的'只展示不判 flag。
- 修改体裁参数前备份对应
profiles/<体裁名>.yaml;references/profiles.example.yaml是结构说明,不会被加载(生效的是profiles/*.yaml或兼容的旧版单文件profiles.yaml)。
相关资讯
-
- ipsupport-code:AI Agent 工具实践指南
- 2026-10-03
-
- project-docs-protocol:AI Agent 工具实践指南
- 2026-10-03
-
- lite-research-agents:AI Agent 工具实践指南
- 2026-10-03
-
- jenkins+gitlab+nginx部署前端应用实现方式实用指南
- 2026-10-03
-
- ai-flavor-less:实践指南
- 2026-10-03
-
- chrona:实践指南
- 2026-10-03